mysql InnoDB count(*/1/id/某个字段) 的区别
一 数据量大了后为什么 count(*) 会变慢?
在系统开发时,我们经常会有统计表数据量的需求,例如无条件分页查询时就需要 count 下得到数据总量去计算总页数。但是当数据量越来越大后 count(*) 也会变得越来越慢。
count(*) 的实现方式(无查询条件):
- mysql MyISAM 会记录每个表的总行数,在查询的时候直接读取返回就好了;
- mysql InnoDB 在每次执行count(*) 时,会去做全表扫描将数据读出来,然后做统计计算得到结果;
为什么 InnoDB 不像 MyISAM 一样维护一个总行数呢?因为 InnoDB 的多版本并发控制(mvcc)的原因,即使是同一时刻不同事务读取到的数据也可能是不同的,也就是读取到的数据总量不一样。
举个例子:
| 事务1 | 事务2 |
|---|---|
| begin; | begin; |
| - | insert into t (插入一条数据) |
| select count(*) from t;(返回100条数据) | select count(*) from t;(返回101条数据) |
可以看到,两个事务,在同时查询的时候,查询到的数据总数不同。这是 InnoDB 的默认事务隔离级别(可重复读)。
当然 InnoDB 也有对 count(*) 做优化,我们知道 InnoDB 底层索引存储结构是 b+ 数,主键索引叶子节点存的是完整的列数据,普通索引叶子节点存的是主键值,所以普通索引相对主键索引来说,数据量会小很多。count( *) 这样的查询操作,读取哪个索引树得到的结果都是一样的,所以 InnoDB 会去遍历数据量最小的那个索引树得到结果。
保障得到结果是正确的前提下,尽量减少扫描的数据量,是数据库设计的通用法则之一。
二 不同 count 的用法
工作中我们不仅会用 count(*) 去做数据统计,可能还会用 count(1)、count(id)、count(某个字段)。那这几种用法有什么区别呢?
在理解上面几种用法的区别前,先搞清楚 count() 的语义,count() 是一个聚合函数,对于返回的结果,会一行行的判断,如果 count() 函数的参数不为 null,就将统计值 + 1,否则不统计该列。
所以 count(*)、count(1)、count(id) 统计的是表的总行数,count(某个字段) 统计的是指定字段不为 null 的总列数。
首先我们来看下实际执行情况:
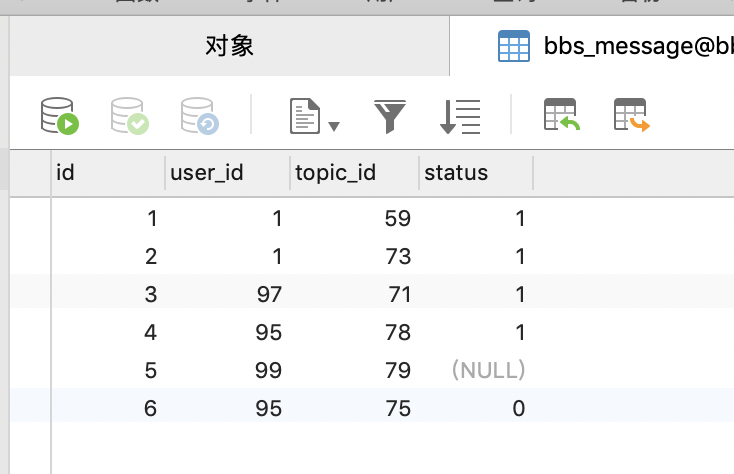
数据表有6条数据,看下不同count查询结果:
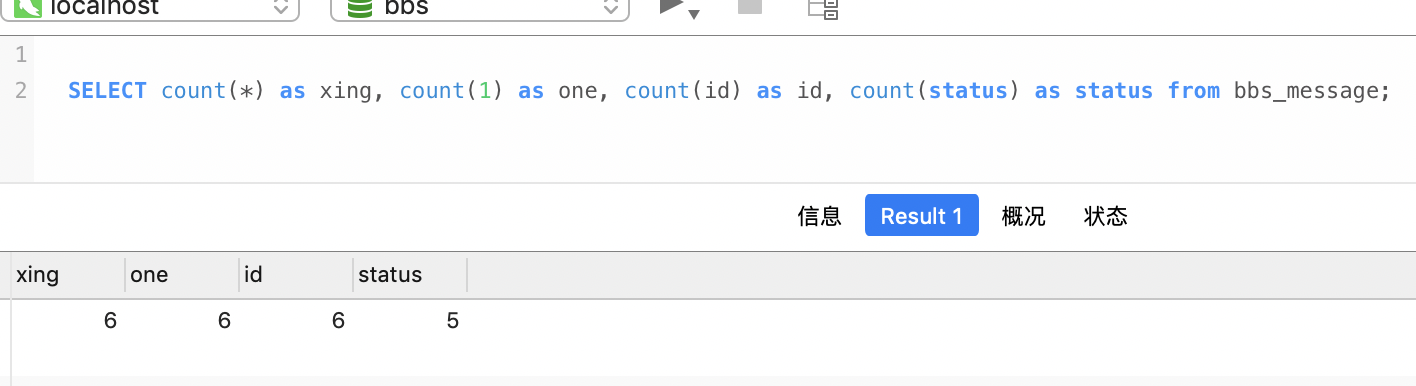
由结果可以看到count不会统计为null的列。
在理解了 count() 语义后,我们再来看看哪个性能会更好,首先来看下几种count的实现:
- count(1):InnoDB 扫描整个表,但不取值,对于每一列都是不可能为空的,所以直接返回1就好了,做+1计算;
- count(id):InnoDB 扫描整个表,取出ID值返回,主键ID是不可能为空的,做+1计算;
- count(某个字段):InnoDB 扫描整个表,如果这个字段定义为 NOT NULL 的话,按行累计统计。如果这个字段定义可为null,还要取出字段值,判断不为null才累加;
所以count(1) 会比 count(id) 快,因为不需要取值。count(某个字段)最慢,还需要取出字段值判断统计。
性能对比结论:count(*) = count(1) > count(id) > count(某个字段);