JDK1.8 LinkedHashMap的实现原理
LinkedHashMap,顾名思义连接的HashMap,它继承了HashMap,HashMap为了避免碰撞,因此用拉链法解决冲突,读过HashMap源码的读者可能会想:HashMap桶中的节点本来就是连接的呀?为什么还要引入LinkedHashMap呢?HashMap中的连接只是同一个桶中的元素连接,而LinkedHashMap是将所有桶中的节点串联成一个双向链表。
如下图所示:
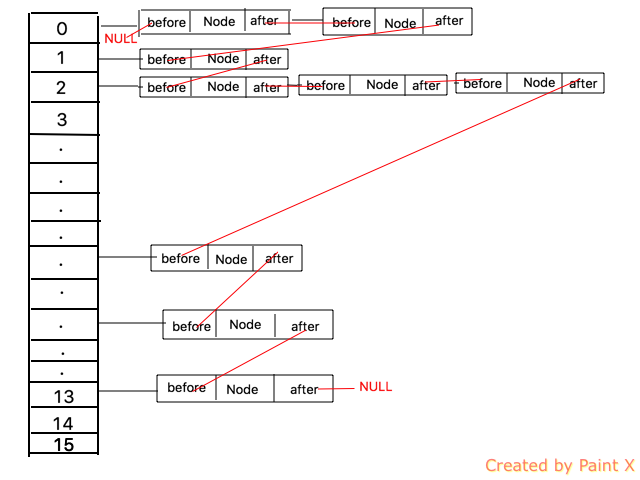
它继承了HashMap的Node,Node基础上添加了before和after两个指针,
 static class Entry<K,V> extends HashMap.Node<K,V> {
    Entry<K,V> before, after;
    Entry(int hash, K key, V value, Node<K,V> next) {
        super(hash, key, value, next);
    }
}
LinkedHashMap使用的是LRU算法(最近最少使用)
当你插入元素时它会将节点插入双向链表的链尾,如果key重复,则也会将节点移动至链尾,当用get()方法获取value时也会将节点移动至链尾。
LinkedHashMap的put()方法是调用的HashMap的put()方法,你可能会问,调用的同一个方法那怎么实现上面说的功能啊?
我们先了解一下它的构造方法:
//accessOrder默认为false,即按照插入顺序来连接,true则为按照访问顺序来连接
public LinkedHashMap(int initialCapacity, float loadFactor) {
    super(initialCapacity, loadFactor);
    accessOrder = false;
}
public LinkedHashMap(int initialCapacity) {
    super(initialCapacity);
    accessOrder = false;
}
public LinkedHashMap() {
    super();
    accessOrder = false;
}
public LinkedHashMap(Map<? extends K, ? extends V> m) {
    super();
    accessOrder = false;
    putMapEntries(m, false);
}
public LinkedHashMap(int initialCapacity,
                     float loadFactor,
                     boolean accessOrder) {
    super(initialCapacity, loadFactor);
    this.accessOrder = accessOrder;
}
别急,我们再先来看一下putVal()的代码:
 if ((p = tab[i = (n - 1) & hash]) == null)
     //调用newNode()方法
    tab[i] = newNode(hash, key, value, null);
else {
    Node<K,V> e; K k;
    if (p.hash == hash &&
        ((k = p.key) == key || (key != null && key.equals(k))))
        e = p;
    else if (p instanceof TreeNode)
        e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
    else {
        for (int binCount = 0; ; ++binCount) {
            if ((e = p.next) == null) {
                  //同上
                p.next = newNode(hash, key, value, null);
                if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
                    treeifyBin(tab, hash);
                break;
            }
            if (e.hash == hash &&
                ((k = e.key) == key || (key != null && key.equals(k))))
                break;
            p = e;
        }
    }
其创建节点的方法是newNode()方法,而LinkedHashMap重写了这个方法:
Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) {
    LinkedHashMap.Entry<K,V> p =
        new LinkedHashMap.Entry<K,V>(hash, key, value, e);
        //将节点插入链尾
    linkNodeLast(p);
    return p;
}
private void linkNodeLast(LinkedHashMap.Entry<K,V> p) {
    LinkedHashMap.Entry<K,V> last = tail;
    tail = p;
    // 如果链尾为空,则双向链表为空,则p即为头结点也为尾节点
    if (last == null)
        head = p;
    else {
        //否则的话修改指针,让之前链尾的after指针指向p,p的before指向之前链尾
        p.before = last;
        last.after = p;
    }
}
那么以上就完成了在插入新值时将其插入双向链表链尾,那么接下来put()更新值则节点移动至链尾怎么实现的呢?
if (e != null) { // existing mapping for key
                V oldValue = e.value;
                if (!onlyIfAbsent || oldValue == null)
                    e.value = value;
                  //在节点被访问后移动链尾
                afterNodeAccess(e);
                return oldValue;
            }
        }
HashMap的put()方法早已包含此方法,不过尚未实现,而LinkedHashMap则实现了此方法:
void afterNodeAccess(Node<K,V> e) { // move node to last
    LinkedHashMap.Entry<K,V> last;
    if (accessOrder && (last = tail) != e) {
        LinkedHashMap.Entry<K,V> p =
            (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after;
         // 因为要移动到链尾,所以先至尾指针为空
        p.after = null;
        //如果前面没有元素,则p之前为头结点,直接让a成为头结点
        if (b == null)
            head = a;
        else
            // 否则b的尾指针指向a
            b.after = a;
        if (a != null)
            //如果a不为空,则a的头指针指向b
            a.before = b;
        else
        //否则 p之前就为尾指针,则另b成为尾指针
            last = b;
        if (last == null)
            //如果双向链表中只有p一个节点,则令p即为头结点,也为尾节点
            head = p;
        else {
        //否则 将p插入链尾
            p.before = last;
            last.after = p;
        }
        tail = p;
        ++modCount;
    }
}
 /**
 *      p将引用移除
 *              b          |          p            |          a
 *       -------------     |     -------------     |     -------------
 *      |before| after| <==|==> |before| after| <==|==> |before| after|
 *       -------------     |     -------------     |     -------------
 *
 *     1.b为NULL时,则a变为头结点
 *                           head
 *                             a                          p
 *       (b)             -------------                -------------
 *      NULL    <------ |before| after|  ......      |before| after| (p最后将插入链尾)
 *                       -------------                -------------
 *     2.a为NULL时,则b变为链尾节点
 *
 *             tail
 *              b                                           p
 *       -------------             (a)                -------------
 *      |before| after|  ------->  NULL   ......     |before| after| (p最后将插入链尾)
 *       -------------                                -------------
 *     3.a,b都为NULL时,p即为头结点,又为尾节点
 *
 *     因为p前后都没有元素,则双向链表中只有p一个节点
 *
 */
LinkedHashMap重写了get()方法,实现了LRU
public V get(Object key) {
    Node<K,V> e;
    if ((e = getNode(hash(key), key)) == null)
        return null;
        // accessOder为true时,被访问的节点被置于双向链表尾部
    if (accessOrder)
        afterNodeAccess(e);
    return e.value;
}
此外HashMap的putVal()方法,还调用了afterNodeInsertion()方法,
void afterNodeInsertion(boolean evict) { // possibly remove eldest
    LinkedHashMap.Entry<K,V> first;
    if (evict && (first = head) != null && removeEldestEntry(first)) {
        K key = first.key;
        removeNode(hash(key), key, null, false, true);
    }
}
即当插入时,将双向链表的头结点移除,这几个方法让LinkedHashMap实现了LRU算法。不过removeEldestEntry()默认是返回false的,需要子类继承重写removeEldestEntry()方法。
LinkedHashMap的remove()方法也是调用的HashMap的remove()方法,
public V remove(Object key) {
    Node<K,V> e;
    return (e = removeNode(hash(key), key, null, false, true)) == null ?
        null : e.value;
}
final Node<K,V> removeNode(int hash, Object key, Object value,
                               boolean matchValue, boolean movable) {
        Node<K,V>[] tab; Node<K,V> p; int n, index;
        if ((tab = table) != null && (n = tab.length) > 0 &&
            (p = tab[index = (n - 1) & hash]) != null) {
            Node<K,V> node = null, e; K k; V v;
            if (p.hash == hash &&
                ((k = p.key) == key || (key != null && key.equals(k))))
                node = p;
            else if ((e = p.next) != null) {
                if (p instanceof TreeNode)
                    node = ((TreeNode<K,V>)p).getTreeNode(hash, key);
                else {
                    do {
                        if (e.hash == hash &&
                            ((k = e.key) == key ||
                             (key != null && key.equals(k)))) {
                            node = e;
                            break;
                        }
                        p = e;
                    } while ((e = e.next) != null);
                }
            }
            if (node != null && (!matchValue || (v = node.value) == value ||
                                 (value != null && value.equals(v)))) {
                if (node instanceof TreeNode)
                    ((TreeNode<K,V>)node).removeTreeNode(this, tab, movable);
                else if (node == p)
                    tab[index] = node.next;
                else
                    p.next = node.next;
                ++modCount;
                --size;
                //回调从双向链表中移除node
                afterNodeRemoval(node);
                return node;
            }
        }
        return null;
    }
同样的也有一个afterNodeRemoval()回调方法,用于将节点从双向链表移除
LinkedHashIterator() {
    next = head;
    expectedModCount = modCount;
    current = null;
}

public final boolean hasNext() {
    return next != null;
}

final LinkedHashMap.Entry<K,V> nextNode() {
    LinkedHashMap.Entry<K,V> e = next;
    if (modCount != expectedModCount)
        throw new ConcurrentModificationException();
    if (e == null)
        throw new NoSuchElementException();
    current = e;
    next = e.after;
    return e;
}
我们可以看到,LlinkedHashMap的iterator也是遍历的双向链表。说了这么多
其实想一想也是很简单的,不过就是Node多了两个指针而已嘛=v=