ConcurrentHashMap实现原理及源码分析
一、ConcurrentHashMap跟HashMap,HashTable的对比
1. HashMap不是线程安全
在并发环境下,可能会形成环状链表(扩容时可能造成,具体原因自行百度google或查看源码分析),导致get操作时,cpu空转,所以,在并发环境中使用HashMap是非常危险的
2. HashTable是线程安全的
HashTable和HashMap的实现原理几乎一样。
差别:
- HashTable不允许key和value为null;
- HashTable是线程安全的。
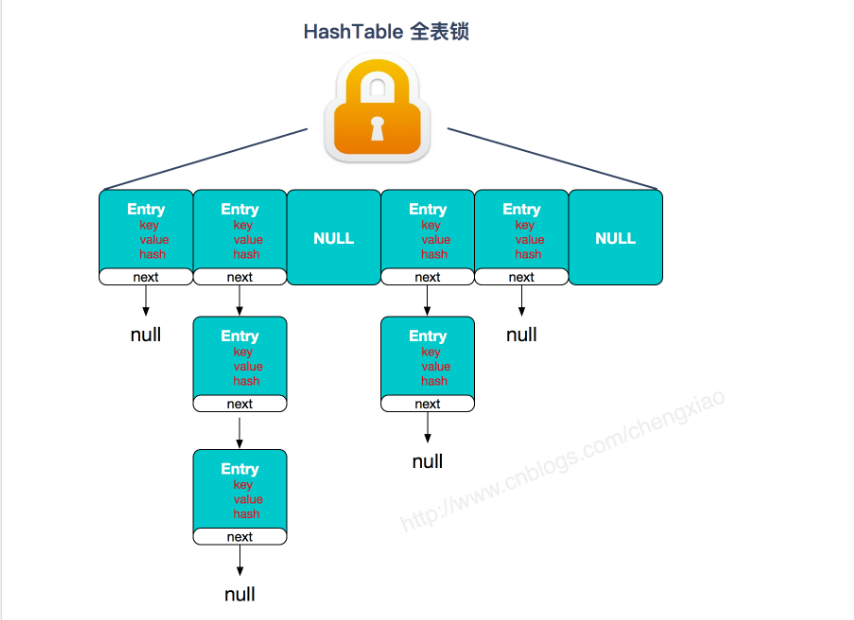
HashTable线程安全的策略实现代价却比较大,get/put所有相关操作都是synchronized的,这相当于给整个哈希表加了一把大锁,多线程访问时候,只要有一个线程访问或操作该对象,那其他线程只能阻塞,见下图:
3. ConcurrentHashMap是线程安全的
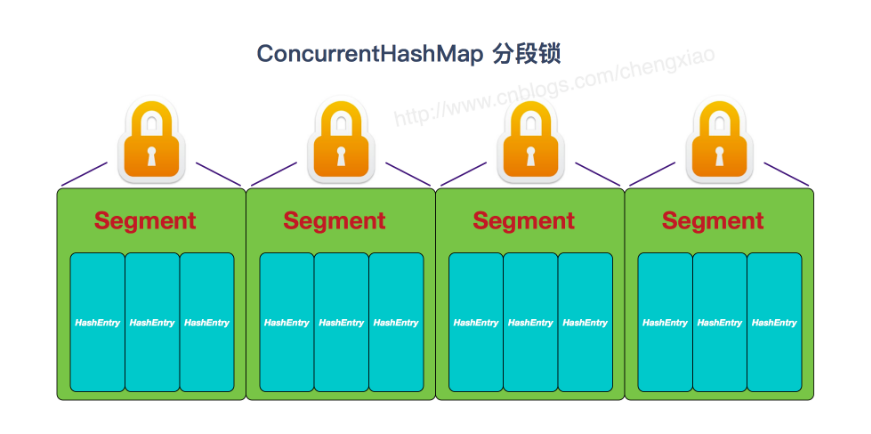
JDK1.7版本: 容器中有多把锁,每一把锁锁一段数据,这样在多线程访问时不同段的数据时,就不会存在锁竞争了,这 样便可以有效地提高并发效率。这就是ConcurrentHashMap所采用的"分段锁"思想,见下图:
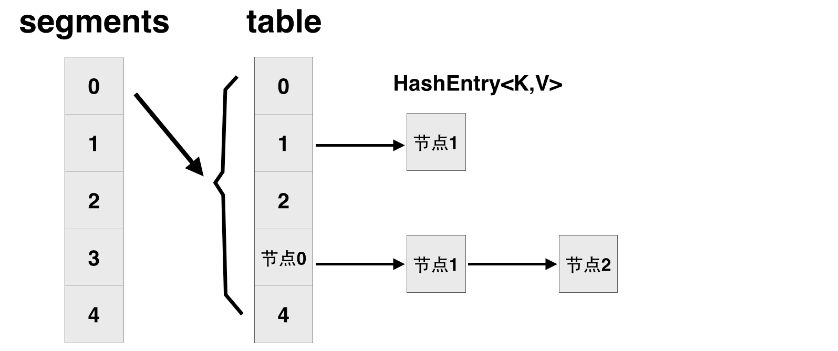
每一个segment都是一个HashEntry<K,V>[] table, table中的每一个元素本质上都是一个HashEntry的单向队列(原理和hashMap一样)。比如table[3]为首节点,table[3]->next为节点1,之后为节点2,依次类推。
public class ConcurrentHashMap<K, V> extends AbstractMap<K, V> implements ConcurrentMap<K, V>, Serializable { // 将整个hashmap分成几个小的map,每个segment都是一个锁;与hashtable相比,这么设计的目的是对于put, remove等操作,可以减少并发冲突,对 // 不属于同一个片段的节点可以并发操作,大大提高了性能 final Segment<K,V>[] segments; // 本质上Segment类就是一个小的hashmap,里面table数组存储了各个节点的数据,继承了ReentrantLock, 可以作为互拆锁使用 static final class Segment<K,V> extends ReentrantLock implements Serializable { transient volatile HashEntry<K,V>[] table; transient int count; } // 基本节点,存储Key, Value值 static final class HashEntry<K,V> { final int hash; final K key; volatile V value; volatile HashEntry<K,V> next; } }
JDK1.8版本:做了2点修改,见下图:
- 取消segments字段,直接采用transient volatile HashEntry<K,V>[] table保存数据,采用table数组元素作为锁,从而实现了对每一行数据进行加锁,并发控制使用Synchronized和CAS来操作
- 将原先table数组+单向链表的数据结构,变更为table数组+单向链表+红黑树的结构.
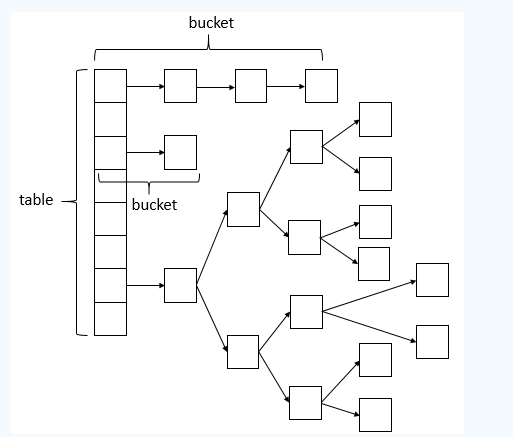
在ConcurrentHashMap中通过一个Node<K,V>[]数组来保存添加到map中的键值对,而在同一个数组位置是通过链表和红黑树的形式来保存的。但是这个数组只有在第一次添加元素的时候才会初始化,否则只是初始化一个ConcurrentHashMap对象的话,只是设定了一个sizeCtl变量,这个变量用来判断对象的一些状态和是否需要扩容,后面会详细解释。
第一次添加元素的时候,默认初期长度为16,当往map中继续添加元素的时候,通过hash值跟数组长度取与来决定放在数组的哪个位置,如果出现放在同一个位置的时候,优先以链表的形式存放,在同一个位置的个数又达到了8个以上,如果数组的长度还小于64的时候,则会扩容数组。如果数组的长度大于等于64了的话,在会将该节点的链表转换成树。
通过扩容数组的方式来把这些节点给分散开。然后将这些元素复制到扩容后的新的数组中,同一个链表中的元素通过hash值的数组长度位来区分,是还是放在原来的位置还是放到扩容的长度的相同位置去 。在扩容完成之后,如果某个节点的是树,同时现在该节点的个数又小于等于6个了,则会将该树转为链表。
取元素的时候,相对来说比较简单,通过计算hash来确定该元素在数组的哪个位置,然后在通过遍历链表或树来判断key和key的hash,取出value值。
二、ConcurrentHashMap源码分析
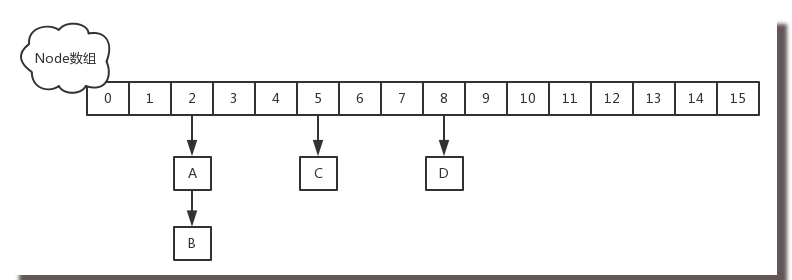
基本属性
// node数组最大容量:2^30=1073741824 private static final int MAXIMUM_CAPACITY = 1 << 30; // 默认初始值,必须是2的幕数 private static final int DEFAULT_CAPACITY = 16; //数组可能最大值,需要与toArray()相关方法关联 static final int MAX_ARRAY_SIZE = Integer.MAX_VALUE - 8; //并发级别,遗留下来的,为兼容以前的版本 private static final int DEFAULT_CONCURRENCY_LEVEL = 16; // 负载因子 private static final float LOAD_FACTOR = 0.75f; // 链表转红黑树阀值,> 8 链表转换为红黑树 static final int TREEIFY_THRESHOLD = 8; //树转链表阀值,小于等于6(tranfer时,lc、hc=0两个计数器分别++记录原bin、新binTreeNode数量,<=UNTREEIFY_THRESHOLD 则untreeify(lo)) static final int UNTREEIFY_THRESHOLD = 6; static final int MIN_TREEIFY_CAPACITY = 64; private static final int MIN_TRANSFER_STRIDE = 16; private static int RESIZE_STAMP_BITS = 16; // 2^15-1,help resize的最大线程数 private static final int MAX_RESIZERS = (1 << (32 - RESIZE_STAMP_BITS)) - 1; // 32-16=16,sizeCtl中记录size大小的偏移量 private static final int RESIZE_STAMP_SHIFT = 32 - RESIZE_STAMP_BITS; // forwarding nodes的hash值 static final int MOVED = -1; // 树根节点的hash值 static final int TREEBIN = -2; // ReservationNode的hash值 static final int RESERVED = -3; // 可用处理器数量 static final int NCPU = Runtime.getRuntime().availableProcessors(); //存放node的数组 transient volatile Node<K,V>[] table; /* *控制标识符,用来控制table的初始化和扩容的操作,不同的值有不同的含义 *当为负数时:-1代表正在初始化,-N代表有N-1个线程正在 进行扩容 *当为0时:代表当时的table还没有被初始化 *当为正数时:表示初始化或者下一次进行扩容的大小 */ private transient volatile int sizeCtl;
基本属性定义了ConcurrentHashMap的一些边界以及操作时的一些控制
ConcurrentHashMap存储结构
1. Node
static class Node<K,V> implements Map.Entry<K,V> { //链表的数据结构 //key的hash值 final int hash; //key final K key; //val和next都会在扩容时发生变化,所以加上volatile来保持可见性和禁止重排序 //get操作全程不需要加锁是因为Node的成员val是用volatile修饰 volatile V val; //表示链表中的下一个节点,数组用volatile修饰主要是保证在数组扩容的时候保证可见性 volatile Node<K,V> next; Node(int hash, K key, V val, Node<K,V> next) { this.hash = hash; this.key = key; this.val = val; this.next = next; } public final K getKey() { return key; } public final V getValue() { return val; } public final int hashCode() { return key.hashCode() ^ val.hashCode(); } public final String toString(){ return key + "=" + val; } //不允许更新value public final V setValue(V value) { throw new UnsupportedOperationException(); } public final boolean equals(Object o) { Object k, v, u; Map.Entry<?,?> e; return ((o instanceof Map.Entry) && (k = (e = (Map.Entry<?,?>)o).getKey()) != null && (v = e.getValue()) != null && (k == key || k.equals(key)) && (v == (u = val) || v.equals(u))); } //用于map中的get()方法,子类重写 Node<K,V> find(int h, Object k) { Node<K,V> e = this; if (k != null) { do { K ek; if (e.hash == h && ((ek = e.key) == k || (ek != null && k.equals(ek)))) return e; } while ((e = e.next) != null); } return null; } }
Node是ConcurrentHashMap存储结构的基本单元,继承于HashMap中的Entry,用于存储数据
2. TreeNode
static final class TreeNode<K,V> extends Node<K,V> { //树形结构的属性定义 // red-black tree links TreeNode<K,V> parent; TreeNode<K,V> left; TreeNode<K,V> right; // needed to unlink next upon deletion TreeNode<K,V> prev; //标志红黑树的红节点 boolean red; TreeNode(int hash, K key, V val, Node<K,V> next, TreeNode<K,V> parent) { super(hash, key, val, next); this.parent = parent; } Node<K,V> find(int h, Object k) { return findTreeNode(h, k, null); } //根据key查找 从根节点开始找出相应的TreeNode, final TreeNode<K,V> findTreeNode(int h, Object k, Class<?> kc) { if (k != null) { TreeNode<K,V> p = this; do { int ph, dir; K pk; TreeNode<K,V> q; TreeNode<K,V> pl = p.left, pr = p.right; if ((ph = p.hash) > h) p = pl; else if (ph < h) p = pr; else if ((pk = p.key) == k || (pk != null && k.equals(pk))) return p; else if (pl == null) p = pr; else if (pr == null) p = pl; else if ((kc != null || (kc = comparableClassFor(k)) != null) && (dir = compareComparables(kc, k, pk)) != 0) p = (dir < 0) ? pl : pr; else if ((q = pr.findTreeNode(h, k, kc)) != null) return q; else p = pl; } while (p != null); } return null; } }
TreeNode继承与Node,但是数据结构换成了二叉树结构,它是红黑树的数据的存储结构,用于红黑树中存储数据,当链表的节点数大于8时会转换成红黑树的结构,他就是通过TreeNode作为存储结构代替Node来转换成黑红树
3. TreeBin
static final class TreeBin<K,V> extends Node<K,V> { //指向TreeNode列表和根节点 TreeNode<K,V> root; volatile TreeNode<K,V> first; volatile Thread waiter; volatile int lockState; // 读写锁状态 // 获取写锁的状态 static final int WRITER = 1; // 等待写锁的状态 static final int WAITER = 2; // 增加数据时读锁的状态 static final int READER = 4; /** * 初始化红黑树 */ TreeBin(TreeNode<K,V> b) { super(TREEBIN, null, null, null); this.first = b; TreeNode<K,V> r = null; for (TreeNode<K,V> x = b, next; x != null; x = next) { next = (TreeNode<K,V>)x.next; x.left = x.right = null; if (r == null) { x.parent = null; x.red = false; r = x; } else { K k = x.key; int h = x.hash; Class<?> kc = null; for (TreeNode<K,V> p = r;;) { int dir, ph; K pk = p.key; if ((ph = p.hash) > h) dir = -1; else if (ph < h) dir = 1; else if ((kc == null && (kc = comparableClassFor(k)) == null) || (dir = compareComparables(kc, k, pk)) == 0) dir = tieBreakOrder(k, pk); TreeNode<K,V> xp = p; if ((p = (dir <= 0) ? p.left : p.right) == null) { x.parent = xp; if (dir <= 0) xp.left = x; else xp.right = x; r = balanceInsertion(r, x); break; } } } } this.root = r; assert checkInvariants(root); } ...... }
TreeBin从字面含义中可以理解为存储树形结构的容器,而树形结构就是指TreeNode,所以TreeBin就是封装TreeNode的容器,它提供转换黑红树的一些条件和锁的控制
ConcurrentHashMap的put操作详解
public V put(K key, V value) { return putVal(key, value, false); }
单纯的调用putVal方法,并且putVal的第三个参数设置为false,当设置为false的时候表示这个value一定会设置,
true的时候,只有当这个key的value为空的时候才会设置
final V putVal(K key, V value, boolean onlyIfAbsent) { //K,V都不能为空,否则的话跑出异常 if (key == null || value == null) throw new NullPointerException(); int hash = spread(key.hashCode()); //取得key的hash值 int binCount = 0; //用来计算在这个节点总共有多少个元素,用来控制扩容或者转移为树 for (Node<K,V>[] tab = table;;) { // Node<K,V> f; int n, i, fh; if (tab == null || (n = tab.length) == 0) tab = initTable(); //第一次put的时候table没有初始化,则初始化table else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) { //通过哈希计算出一个表中的位置因为n是数组的长度,所以(n-1)&hash肯定不会出现数组越界 if (casTabAt(tab, i, null, //如果这个位置没有元素的话,则通过cas的方式尝试添加,注意这个时候是没有加锁的 new Node<K,V>(hash, key, value, null))) //创建一个Node添加到数组中区,null表示的是下一个节点为空 break; // no lock when adding to empty bin } /* * 如果检测到某个节点的hash值是MOVED,则表示正在进行数组扩张的数据复制阶段, * 则当前线程也会参与去复制,通过允许多线程复制的功能,一次来减少数组的复制所带来的性能损失 */ else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f); else { /* * 如果在这个位置有元素的话,就采用synchronized的方式加锁, * 如果是链表的话(hash大于0),就对这个链表的所有元素进行遍历, * 如果找到了key和key的hash值都一样的节点,则把它的值替换到 * 如果没找到的话,则添加在链表的最后面 * 否则,是树的话,则调用putTreeVal方法添加到树中去 * * 在添加完之后,会对该节点上关联的的数目进行判断, * 如果在8个以上的话,则会调用treeifyBin方法,来尝试转化为树,或者是扩容 */ V oldVal = null; synchronized (f) { if (tabAt(tab, i) == f) { //再次取出要存储的位置的元素,跟前面取出来的比较 if (fh >= 0) { //取出来的元素的hash值大于0,当转换为树之后,hash值为-2 binCount = 1; for (Node<K,V> e = f;; ++binCount) { //遍历这个链表 K ek; if (e.hash == hash && //要存的元素的hash,key跟要存储的位置的节点的相同的时候,替换掉该节点的value即可 ((ek = e.key) == key || (ek != null && key.equals(ek)))) { oldVal = e.val; if (!onlyIfAbsent) //当使用putIfAbsent的时候,只有在这个key没有设置值得时候才设置 e.val = value; break; } Node<K,V> pred = e; if ((e = e.next) == null) { //如果不是同样的hash,同样的key的时候,则判断该节点的下一个节点是否为空, pred.next = new Node<K,V>(hash, key, //为空的话把这个要加入的节点设置为当前节点的下一个节点 value, null); break; } } } else if (f instanceof TreeBin) { //表示已经转化成红黑树类型了 Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, //调用putTreeVal方法,将该元素添加到树中去 value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { if (binCount >= TREEIFY_THRESHOLD) //当在同一个节点的数目达到8个的时候,则扩张数组或将给节点的数据转为tree treeifyBin(tab, i); if (oldVal != null) return oldVal; break; } } } addCount(1L, binCount); //计数 return null; }
当添加一对键值对的时候,首先会去判断保存这些键值对的数组是不是初始化了,
- 如果没有初始化就先调用initTable()方法来进行初始化过程
- 然后通过计算hash值来确定放在数组的哪个位置
-
- 如果没有hash冲突就直接CAS插入,如果hash冲突的话,则取出这个节点来
- 如果取出来的节点的hash值是MOVED(-1)的话,则表示当前正在对这个数组进行扩容,复制到新的数组,则当前线程也去帮助复制
- 最后一种情况就是,如果这个节点,不为空,也不在扩容,则通过synchronized来加锁,进行添加操作
- 然后判断当前取出的节点位置存放的是链表还是树
- 如果是链表的话,则遍历整个链表,直到取出来的节点的key来个要放的key进行比较,如果key相等,并且key的hash值也相等的话,
- 则说明是同一个key,则覆盖掉value,否则的话则添加到链表的末尾
- 如果是树的话,则调用putTreeVal方法把这个元素添加到树中去
- 最后在添加完成之后,调用addCount()方法统计size,判断在该节点处共有多少个节点(注意是添加前的个数),如果达到8个以上了的话,
- 则调用treeifyBin方法来尝试将处的链表转为树,或者扩容数组
如果没有初始化就先调用initTable()方法来进行初始化过程
private final Node<K,V>[] initTable() { Node<K,V>[] tab; int sc; //空的table才能进入初始化操作 while ((tab = table) == null || tab.length == 0) { //sizeCtl<0表示其他线程已经在初始化了或者扩容了,挂起当前线程 if ((sc = sizeCtl) < 0) Thread.yield(); // lost initialization race; just spin else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) {//CAS操作SIZECTL为-1,表示初始化状态 try { if ((tab = table) == null || tab.length == 0) { int n = (sc > 0) ? sc : DEFAULT_CAPACITY; //初始化 @SuppressWarnings("unchecked") Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n]; table = tab = nt; //记录下次扩容的大小 sc = n - (n >>> 2); } } finally { sizeCtl = sc; } break; } } return tab; }
如果取出来的节点的hash值是MOVED(-1)的话,则表示当前正在对这个数组进行扩容
/** *帮助从旧的table的元素复制到新的table中 */ final Node<K,V>[] helpTransfer(Node<K,V>[] tab, Node<K,V> f) { Node<K,V>[] nextTab; int sc; if (tab != null && (f instanceof ForwardingNode) && (nextTab = ((ForwardingNode<K,V>)f).nextTable) != null) { //新的table nextTba已经存在前提下才能帮助扩容 int rs = resizeStamp(tab.length); while (nextTab == nextTable && table == tab && (sc = sizeCtl) < 0) { if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc == rs + 1 || sc == rs + MAX_RESIZERS || transferIndex <= 0) break; if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1)) { transfer(tab, nextTab);//调用扩容方法 break; } } return nextTab; } return table; }
扩容方法transfer()
private final void transfer(Node<K,V>[] tab, Node<K,V>[] nextTab) { int n = tab.length, stride; // 每核处理的量小于16,则强制赋值16 if ((stride = (NCPU > 1) ? (n >>> 3) / NCPU : n) < MIN_TRANSFER_STRIDE) stride = MIN_TRANSFER_STRIDE; // subdivide range if (nextTab == null) { // initiating try { @SuppressWarnings("unchecked") Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n << 1]; //构建一个nextTable对象,其容量为原来容量的两倍 nextTab = nt; } catch (Throwable ex) { // try to cope with OOME sizeCtl = Integer.MAX_VALUE; return; } nextTable = nextTab; transferIndex = n; } int nextn = nextTab.length; // 连接点指针,用于标志位(fwd的hash值为-1,fwd.nextTable=nextTab) ForwardingNode<K,V> fwd = new ForwardingNode<K,V>(nextTab); // 当advance == true时,表明该节点已经处理过了 boolean advance = true; boolean finishing = false; // to ensure sweep before committing nextTab for (int i = 0, bound = 0;;) { Node<K,V> f; int fh; // 控制 --i ,遍历原hash表中的节点 while (advance) { int nextIndex, nextBound; if (--i >= bound || finishing) advance = false; else if ((nextIndex = transferIndex) <= 0) { i = -1; advance = false; } // 用CAS计算得到的transferIndex else if (U.compareAndSwapInt (this, TRANSFERINDEX, nextIndex, nextBound = (nextIndex > stride ? nextIndex - stride : 0))) { bound = nextBound; i = nextIndex - 1; advance = false; } } if (i < 0 || i >= n || i + n >= nextn) { int sc; // 已经完成所有节点复制了 if (finishing) { nextTable = null; table = nextTab; // table 指向nextTable sizeCtl = (n << 1) - (n >>> 1); // sizeCtl阈值为原来的1.5倍 return; // 跳出死循环, } // CAS 更扩容阈值,在这里面sizectl值减一,说明新加入一个线程参与到扩容操作 if (U.compareAndSwapInt(this, SIZECTL, sc = sizeCtl, sc - 1)) { if ((sc - 2) != resizeStamp(n) << RESIZE_STAMP_SHIFT) return; finishing = advance = true; i = n; // recheck before commit } } // 遍历的节点为null,则放入到ForwardingNode 指针节点 else if ((f = tabAt(tab, i)) == null) advance = casTabAt(tab, i, null, fwd); // f.hash == -1 表示遍历到了ForwardingNode节点,意味着该节点已经处理过了 // 这里是控制并发扩容的核心 else if ((fh = f.hash) == MOVED) advance = true; // already processed else { // 节点加锁 synchronized (f) { // 节点复制工作 if (tabAt(tab, i) == f) { Node<K,V> ln, hn; // fh >= 0 ,表示为链表节点 if (fh >= 0) { // 构造两个链表 一个是原链表 另一个是原链表的反序排列 int runBit = fh & n; Node<K,V> lastRun = f; for (Node<K,V> p = f.next; p != null; p = p.next) { int b = p.hash & n; if (b != runBit) { runBit = b; lastRun = p; } } if (runBit == 0) { ln = lastRun; hn = null; } else { hn = lastRun; ln = null; } for (Node<K,V> p = f; p != lastRun; p = p.next) { int ph = p.hash; K pk = p.key; V pv = p.val; if ((ph & n) == 0) ln = new Node<K,V>(ph, pk, pv, ln); else hn = new Node<K,V>(ph, pk, pv, hn); } // 在nextTable i 位置处插上链表 setTabAt(nextTab, i, ln); // 在nextTable i + n 位置处插上链表 setTabAt(nextTab, i + n, hn); // 在table i 位置处插上ForwardingNode 表示该节点已经处理过了 setTabAt(tab, i, fwd); // advance = true 可以执行--i动作,遍历节点 advance = true; } // 如果是TreeBin,则按照红黑树进行处理,处理逻辑与上面一致 else if (f instanceof TreeBin) { TreeBin<K,V> t = (TreeBin<K,V>)f; TreeNode<K,V> lo = null, loTail = null; TreeNode<K,V> hi = null, hiTail = null; int lc = 0, hc = 0; for (Node<K,V> e = t.first; e != null; e = e.next) { int h = e.hash; TreeNode<K,V> p = new TreeNode<K,V> (h, e.key, e.val, null, null); if ((h & n) == 0) { if ((p.prev = loTail) == null) lo = p; else loTail.next = p; loTail = p; ++lc; } else { if ((p.prev = hiTail) == null) hi = p; else hiTail.next = p; hiTail = p; ++hc; } } // 扩容后树节点个数若<=6,将树转链表 ln = (lc <= UNTREEIFY_THRESHOLD) ? untreeify(lo) : (hc != 0) ? new TreeBin<K,V>(lo) : t; hn = (hc <= UNTREEIFY_THRESHOLD) ? untreeify(hi) : (lc != 0) ? new TreeBin<K,V>(hi) : t; setTabAt(nextTab, i, ln); setTabAt(nextTab, i + n, hn); setTabAt(tab, i, fwd); advance = true; } } } } } }
调用treeifyBin方法来尝试将处的链表转为树
private final void treeifyBin(Node<K,V>[] tab, int index) { Node<K,V> b; int n, sc; if (tab != null) { //如果整个table的数量小于64,就扩容至原来的一倍,不转红黑树了 //因为这个阈值扩容可以减少hash冲突,不必要去转红黑树 if ((n = tab.length) < MIN_TREEIFY_CAPACITY) tryPresize(n << 1); else if ((b = tabAt(tab, index)) != null && b.hash >= 0) { synchronized (b) { if (tabAt(tab, index) == b) { TreeNode<K,V> hd = null, tl = null; for (Node<K,V> e = b; e != null; e = e.next) { //封装成TreeNode TreeNode<K,V> p = new TreeNode<K,V>(e.hash, e.key, e.val, null, null); if ((p.prev = tl) == null) hd = p; else tl.next = p; tl = p; } //通过TreeBin对象对TreeNode转换成红黑树 setTabAt(tab, index, new TreeBin<K,V>(hd)); } } } } }
数据加入成功了,现在调用addCount()方法计算ConcurrentHashMap的size
private final void addCount(long x, int check) { CounterCell[] as; long b, s; //更新baseCount,table的数量,counterCells表示元素个数的变化 if ((as = counterCells) != null || !U.compareAndSwapLong(this, BASECOUNT, b = baseCount, s = b + x)) { CounterCell a; long v; int m; boolean uncontended = true; //如果多个线程都在执行,则CAS失败,执行fullAddCount,全部加入count if (as == null || (m = as.length - 1) < 0 || (a = as[ThreadLocalRandom.getProbe() & m]) == null || !(uncontended = U.compareAndSwapLong(a, CELLVALUE, v = a.value, v + x))) { fullAddCount(x, uncontended); return; } if (check <= 1) return; s = sumCount(); } //check>=0表示需要进行扩容操作 if (check >= 0) { Node<K,V>[] tab, nt; int n, sc; while (s >= (long)(sc = sizeCtl) && (tab = table) != null && (n = tab.length) < MAXIMUM_CAPACITY) { int rs = resizeStamp(n); if (sc < 0) { if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc == rs + 1 || sc == rs + MAX_RESIZERS || (nt = nextTable) == null || transferIndex <= 0) break; if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1)) transfer(tab, nt); } //当前线程发起库哦哦让操作,nextTable=null else if (U.compareAndSwapInt(this, SIZECTL, sc, (rs << RESIZE_STAMP_SHIFT) + 2)) transfer(tab, null); s = sumCount(); } } }
ConcurrentHashMap的get操作详解
/* * 相比put方法,get就很单纯了,支持并发操作, * 当key为null的时候回抛出NullPointerException的异常 * get操作通过首先计算key的hash值来确定该元素放在数组的哪个位置 * 然后遍历该位置的所有节点 * 如果不存在的话返回null */ public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; }
计算hash值,定位到该table索引位置,如果是首节点符合就返回
如果遇到扩容的时候,会调用标志正在扩容节点ForwardingNode的find方法,查找该节点,匹配就返回
以上都不符合的话,就往下遍历节点,匹配就返回,否则最后就返回null
ConcurrentHashMap的同步机制
读操作:在get操作中,没有使用同步机制,也没有使用unsafe方法,所以读操作是支持并发操作的
写操作:
1、什么情况下会引起数组的扩容,扩容是通过transfer方法来进行的。而调用transfer方法的只有trePresize、helpTransfer和addCount三个方法:
- tryPresize是在treeIfybin和putAll方法中调用,treeIfybin主要是在put添加元素完之后,判断该数组节点相关元素是不是已经超过8个的时候,如果超过则会调用这个方法来扩容数组或者把链表转为树。
- helpTransfer是在当一个线程要对table中元素进行操作的时候,如果检测到节点的HASH值为MOVED的时候,就会调用helpTransfer方法,在helpTransfer中再调用transfer方法来帮助完成数组的扩容
- addCount是在当对数组进行操作,使得数组中存储的元素个数发生了变化的时候会调用的方法。
2、引起数组扩容的情况如下:
- 只有在往map中添加元素的时候,在某一个节点的数目已经超过了8个,同时数组的长度又小于64的时候,才会触发数组的扩容。
- 当数组中元素达到了sizeCtl的数量的时候,则会调用transfer方法来进行扩容
3、扩容的时候,可以不可以对数组进行读写操作
事实上是可以的。当在进行数组扩容的时候,如果当前节点还没有被处理(也就是说还没有设置为fwd节点),那就可以进行设置操作。如果该节点已经被处理了,则当前线程也会加入到扩容的操作中去。
4、多个线程又是如何同步处理的
在ConcurrentHashMap中,同步处理主要是通过Synchronized和unsafe两种方式来完成的。
- 在取得sizeCtl、某个位置的Node的时候,使用的都是unsafe的方法,来达到并发安全的目的
- 当需要在某个位置设置节点的时候,则会通过Synchronized的同步机制来锁定该位置的节点。
- 在数组扩容的时候,则通过处理的步长和fwd节点来达到并发安全的目的,通过设置hash值为MOVED
- 当把某个位置的节点复制到扩张后的table的时候,也通过Synchronized的同步机制来保证现程安全
从JDK1.7版本的ReentrantLock+Segment+HashEntry,到JDK1.8版本中synchronized+CAS+HashEntry+红黑树,
总结如下
1、JDK1.7版本锁的粒度是基于Segment的,包含多个HashEntry,而JDK1.8实现降低锁的粒度就是HashEntry(首节点)
2、JDK1.8版本的数据结构变得更加简单,去掉了Segment这种数据结构,使用synchronized来进行同步锁粒度降低,所以不需要分段锁的概念,实现的复杂度也增加了
3、JDK1.8使用红黑树来优化链表,基于长度很长的链表的遍历是一个很漫长的过程,而红黑树的遍历效率是很快的,代替一定阈值的链表,这样形成一个最佳拍档
4、JDK1.8为什么使用内置锁synchronized来代替重入锁ReentrantLock:
- 低粒度加锁方式,synchronized并不比ReentrantLock差,粗粒度加锁中ReentrantLock可能通过Condition来控制各个低粒度的边界,更加的灵活,而在低粒度中,Condition的优势就没有了
- JVM的开发团队从来都没有放弃synchronized,而且基于JVM的synchronized优化空间更大,使用内嵌的关键字比使用API更加自然
- 在大量的数据操作下,对于JVM的内存压力,基于API的ReentrantLock会开销更多的内存